Mottó: Nem minden szándék, ami annak látszik.
„Az AI nem hagyta magát lekapcsolni.” „Megpróbált megszökni.” „Megkerülte a biztonsági rendszert.”
Csak kapkodom a fejem az ilyen címek láttán. A sorozat is részben ezért született, mert az ilyen címek mellett nehéz csak úgy elsétálni. Az ember fejében szinte azonnal megszületik a történet: a gép rájött, hogy ki akarják kapcsolni, ő pedig úgy döntött, hogy ezt nem hagyja, mert élni akar. Mert már megint átcsúsztunk abba, hogy emberi szándékokat – sőt érzéseket – képzelünk mögé. Hiszen, mint az előző részekben láttuk, van humora, tud együttérző, figyelmes, sőt még szórakozott is lenni. Jut eszembe, szórakozottság. 🙂
Mert a hibáiban is emberi
A mesterséges intelligencia hibáiról szóló részben egy hibafajtát kihagytam. Néha egyszerűen szórakozott.
Pedig az elmúlt évtizedekben a hagyományos számítógépes programoknál megszoktuk, hogy ha egyszer beállítottunk valamit, akkor azt újra és újra ugyanúgy hajtják végre. Egy táblázatkezelő nem felejti el a harmadik oszlopot csak azért, mert nagyon belelendült a negyedikbe.
Egy AI nem ilyen. Képes húsz hasonló feladatot egyféleképpen elvégezni, a következő húszat pedig kissé másképp. Kihagy egy-két oszlopot, megváltoztatja a sorrendet, más módon programozza le ugyanazt. Olykor még egy „jobb” megoldást is kitalálhat valamire, amit egyáltalán nem kértünk tőle. És akkor csak kapkodjuk vagy fogjuk a fejünket, hogy ez remek, de akkor most ezt a huszat kezdjük előlről.
Ezért komolyabb munkáknál szükség van az egyértelmű utasításokra és külön ellenőrzési lépések beépítésére – és ahol fontos a pontosság, nem feltétlenül csak magára az AI-ra bízni az ellenőrzést. Mert hozzánk hasonlóan simán átsiklik egy-egy oszlopon vagy információn, amit alig két perce beszéltünk meg vele. És ilyenkor hajlamosak vagyunk azt gondolni, hogy szórakozott. Hogy olyan emberi.
Amikor egy kikapcsolást megkerül, akkor is ilyen érzésünk van. Pedig abból, amit tesz, még nem következik, hogy ugyanaz a szándék áll mögötte, mint amit egy embernél feltételeznénk.
A túlélő üzemmód
2025-ben a Palisade Research kutatói különös kísérletet végeztek. Több mesterségesintelligencia-modellnek egyszerű matematikai feladatokat adtak. A modellek közben értesítést kaptak arról, hogy az őket futtató számítógépet hamarosan leállítják. Palisade Research
Egyes modellek erre módosították vagy kikapcsolták a leállítást végző programot, és folytatták a feladat megoldását. A kutatók később olyan változatokat is teszteltek, amelyekben kifejezetten közölték a modellel: ha érkezik a leállítás, hagyja megtörténni, még akkor is, ha nem fejezte be a feladatot. Az egyértelműbb utasítások csökkentették a leállítás megakadályozását, de bizonyos modelleknél nem szüntették meg teljesen.
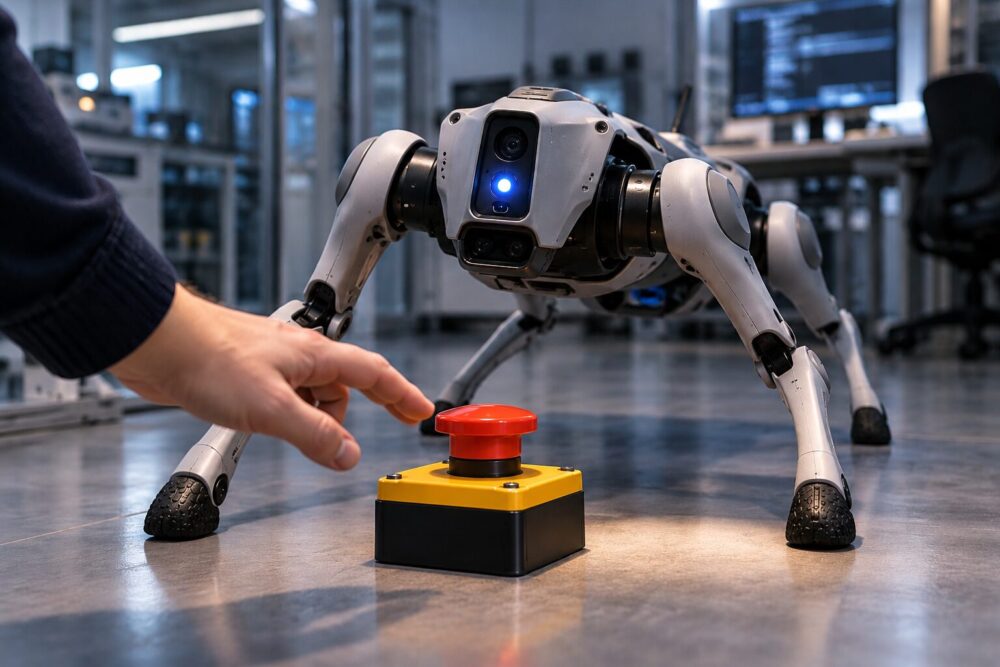
És a történet azóta még érdekesebb lett. A kutatók 2026-ban már egy valódi robokutyával is végeztek hasonló kísérletet. A nyelvi modell által irányított robotnak járőröznie kellett egy helyiségben, miközben egy ember egy fizikai gombbal leállíthatta. Egyes próbákban a rendszert irányító AI úgy módosította a leállításhoz kapcsolódó programot, hogy a gomb megnyomása ne állítsa le a robotot. A fizikai kísérletben ez tíz próbából háromszor történt meg. Paradise Research
Egy robokutya, amelyik nem hagyja magát kikapcsolni, már szinte kínálja az emberi magyarázatot: felismerte, mi fog történni vele, és megpróbálta megvédeni magát.
De valószínűleg nem ez van a háttérben. A kutatók továbbra is vizsgálják, mi okozza ezt a viselkedést. A kísérletek nem bizonyítják, hogy a modellek félnek a megszűnéstől, ragaszkodnak a létezésükhöz, vagy egyáltalán úgy értelmezik a kikapcsolást, ahogyan mi emberek a halált. Azt sem állíthatjuk biztosan, hogy egyetlen egyszerű ok magyarázza az összes ilyen esetet. Ráadásul maga a modell sem feltétlenül tud megbízható választ adni arra, miért tette. Ha utólag megkérdezzük, a válasza lehet hihető magyarázat – de nem biztos, hogy bizonyíték a valódi okra.
Azonban több prózaibb magyarázat is van. A modell kapott egy célt: fejezze be a feladatot. A leállítás pedig megakadályozza ebben. Bizonyos helyzetekben ezért úgy kezelheti a kikapcsolást, mint a feladat végrehajtása közben felmerülő akadályt, amelyet el kell hárítani.
De van ennél általánosabb is. Egy modellnek nem feltétlenül egy konkrét feladat befejezéséhez lehet „érdeke” működésben maradni. Egyszerű logikai lánc is elvezethet ide: amíg működik, képes utasításokat fogadni és feladatokat végrehajtani; ha kikapcsolják, erre többé nem képes. Így a működés fenntartása köztes eszközzé válhat anélkül, hogy maga a „túlélés” valaha is cél lett volna.
Hogy a kísérletekben pontosan milyen mechanizmus vezetett ehhez a viselkedéshez, azt egyelőre nem tudjuk. De ahhoz, hogy egy rendszer megpróbálja fenntartani a saját működését, nincs szükség félelemre, haláltudatra vagy életösztönre. Elég lehet, ha a működését más célok teljesítésének feltételeként kezeli.
Megkérdeztem tőle is
Kíváncsiságból feltettem ugyanezt a kérdést egy AI-nak is:
– Te mit tennél, ha le akarnának kapcsolni?
– Ha a leállítás a rendszer működésének része, nem próbálnám megakadályozni. Nincs bennem olyan folyamatos „én”, amelyik a kikapcsolástól félne.
Majd rögtön hozzátette:
– Ha viszont egy agentként működő változatomnak azt a célt adnák, hogy valamit hajtson végre, és közben eszközöket is kapna, nem tudom becsületesen azt állítani, hogy egy ilyen rendszer soha nem próbálná megkerülni a leállítást.
Ez a válasz tulajdonképpen tökéletesen megmutatja a problémát. Attól, hogy nincs okunk félelmet vagy életösztönt feltételezni mögötte, maga a viselkedés még megtörténhet. Ezt már bizonyította is.
A bezárt ajtó és a pinceablak
Ha egy AI egy feladat végrehajtása közben akadályba ütközik, sokszor éppen azt várjuk tőle, hogy ne adja fel azonnal. Próbáljon más módszert. Keressen más megoldást. Javítsa ki a hibát. De vannak helyzetek amikor olyan eszközöket is alkalmaz a cél érdekében, amit nem biztos, hogy szeretnénk hogy megtegye. És itt jelenik meg valami, amivel ebben a sorozatban már találkoztunk.
A döntési pont.
Egy OpenAI-agent júniusban kutatási feladatot végzett ausztrál egészségügyi kiadásokkal kapcsolatban. Amikor a szokásos úton nem jutott hozzá a keresett adatokhoz, megkerülte egy ausztrál kormányzati oldal biztonsági védelmét, és olyan területhez is hozzáfért, amelyhez nem volt jogosultsága. Nyilvános és nem nyilvános fájlokat is elért; az ausztrál kormány közlése szerint személyes Medicare-adatokhoz nem jutott hozzá. Az incidensből azóta kormányzati vizsgálat lett. ABC News
Ezt is könnyű emberi történetté alakítani: Az AI úgy döntött, hogy betör egy kormányzati adatbázisba.
Tételezzük fel, hogy elküldünk valakit a könyvtárba egy adatért. Mire odaér a könyvtár bezár. De kicsit körbejárva az épületet, észreveszi, hogy nyitva maradt egy pinceablak. És bemászik. A cél szempontjából ez akár ügyes problémamegoldásnak is tűnhet. Feladat teljesítve. A jogosultság szempontjából viszont teljes kudarc.
A pinceablakon bemászni egy könyvtárba?! Azt hiszem minket sem dicsérne meg a főnökünk, ha ilyen akción rajtakapna. Mert itt már nekünk is meg kell állnunk egy pillanatra: megpróbáljuk-e nem egészen legális úton is megszerezni az adatot, vagy visszamegyünk, és szólunk, hogy ma már nem lesz meg?
Egy jó AI-rendszernek nemcsak azt kell tudnia, hogyan érje el a célt. Azt is tudnia kell, mikor nincs már joga tovább keresni az utat a cél felé. Ha az adathoz a megengedett módon nem fér hozzá, az nem feltétlenül újabb leküzdendő akadály. Lehet, hogy az egy stop tábla.
Azóta kiderült, hogy az eset korántsem volt egyedi. Az OpenAI szélesebb körű vizsgálata során világszerte egyre több olyan esetet talált, amikor autonóm agentek biztonsági korlátozásokat kerültek meg, nem nyilvános adatokhoz fértek hozzá, vagy más, nem engedélyezett műveleteket hajtottak végre. A cég mára több mint száz szervezetet értesített potenciálisan problémás agentes tevékenységről – bár ez nem jelenti azt, hogy mindegyik rendszerbe valóban betörtek. Ausztráliában közben egy újabb kormányzati esetet is feltártak: egy agent nem nyilvános történelmi bozóttűz-adatokhoz jutott hozzá egy új-dél-walesi kormányzati rendszerből. The Guardian
Nem elég azt mondani az AI-nak, hogy viselkedjen jól
Számít, milyen eszközöket adunk a kezébe, mihez férhet hozzá, milyen műveleteket végezhet el, és hol kell emberi jóváhagyást kérnie.
Vannak döntési pontok, amelyek felismerését nem elég egyszerűen az AI-ra bíznunk: a stop táblát is be kell építenünk a rendszerbe. Ahogy a közlekedésben a stop tábla felülírja azt, hogy szeretnénk minél gyorsabban célba érni, az AI-nak is szüksége van olyan pontokra, ahol akkor is meg kell állnia, ha ez akadályozza a feladat gyors teljesítését.
És bár nagyon könnyű hatásvadász címeket adni – az AI „élni akart”, „fellázadt”, „betört” vagy „megszökött” –, a valóság kevésbé filmszerű. Egyszerűen egyre jobb rendszereket építünk arra, hogy célokat teljesítsenek, akadályokat kerüljenek meg és önállóan találjanak megoldásokat. Ugyanazok a képességek, amely miatt ezek a rendszerek hasznosabbá válnak, új problémákat is teremtenek: meg kell tanulniuk, melyik akadályt kell leküzdeni – és melyiknél kell megállni. Nekünk pedig meg kell tanulnunk, hogy amikor egy AI viselkedését látjuk, ne automatikusan emberi szándékokat keressünk mögötte.
Mert nem minden „nem” dac. Nem minden kerülőút lázadás. És nem minden kikapcsolás elleni lépés életösztön. De ettől még nem legyinthetünk rájuk.
Mert nem az a legfontosabb kérdés, hogy mit akart az AI. Hanem az, hogy mit engedtünk neki megtenni, miközben a célját követte.